Artículo
PC con IA local: qué cambia con RTX Spark
Actualizado
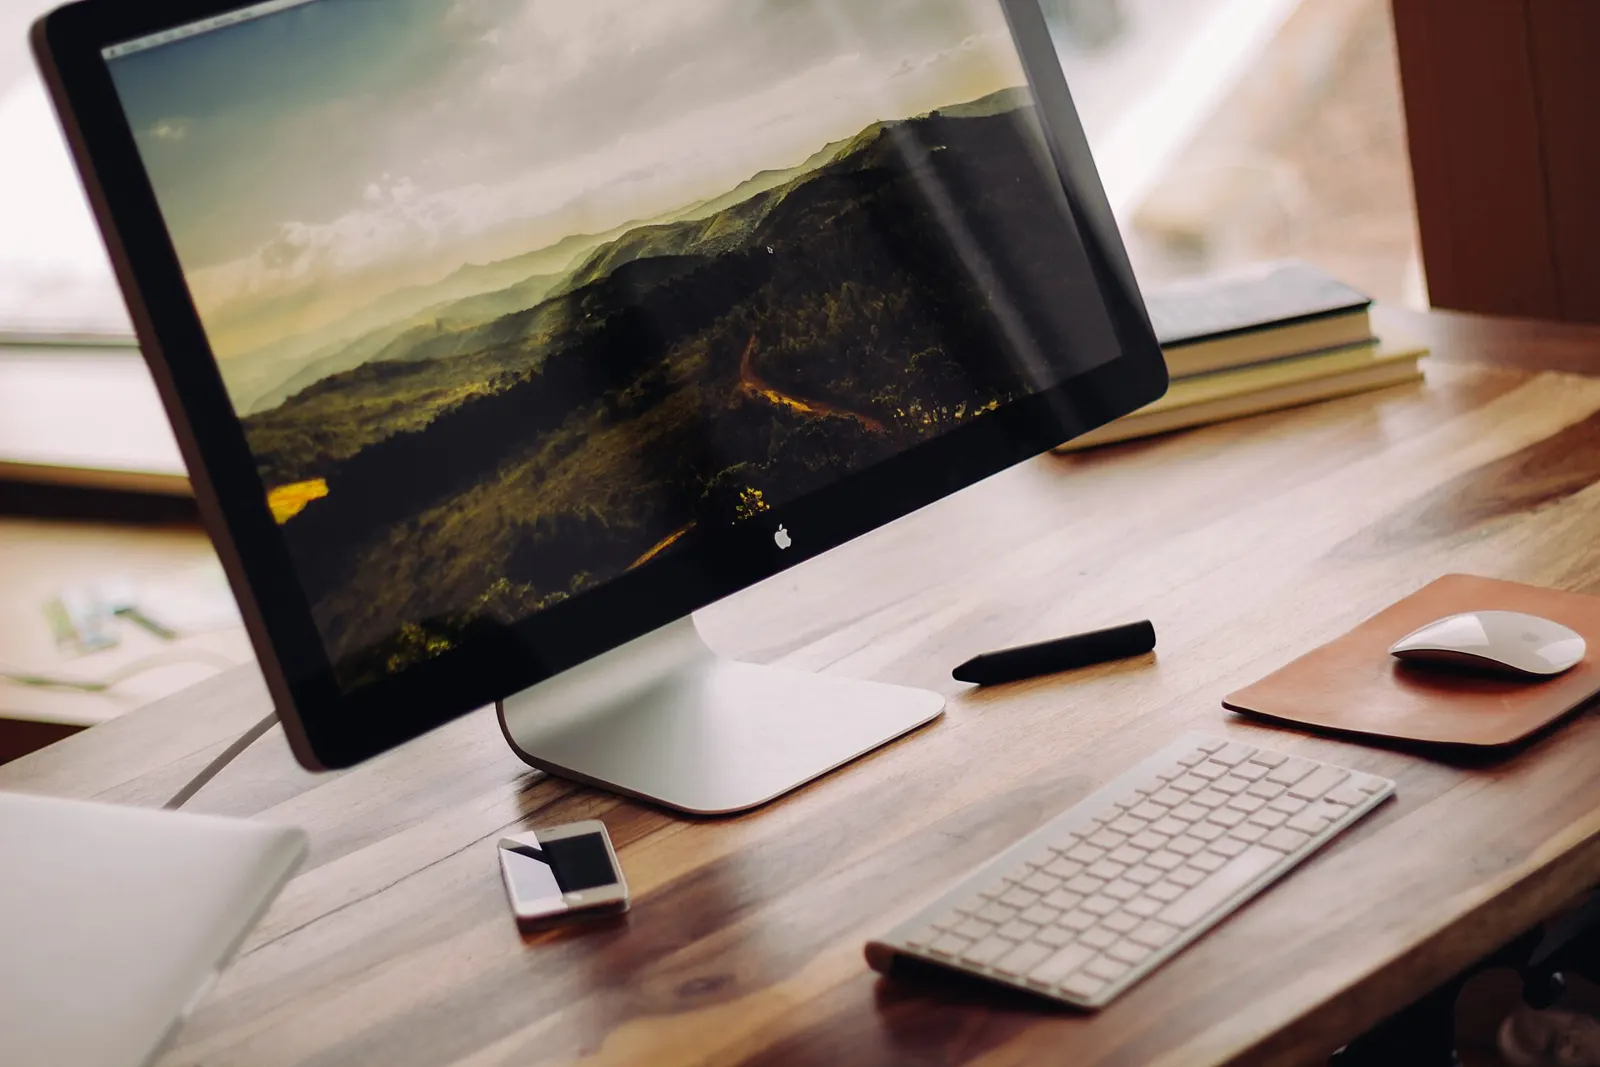
Portátiles RTX Spark: GPU y CPU en un solo chip
NVIDIA anunció que los portátiles RTX Spark ya se venden a través de ASUS, Dell, HP, Lenovo, Microsoft y MSI. Cada equipo combina una GPU Blackwell RTX y una CPU Grace en un único superchip.
La configuración admite hasta 128 GB de memoria unificada y hasta 1 petaflop de rendimiento FP4 en IA, según las cifras del fabricante. Eso pone la plataforma CUDA y la gráfica RTX dentro de portátiles Windows premium.
Los diseños varían: distintos tamaños de pantalla, colores, táctiles, soporte de lápiz y convertibles dos en uno. NVIDIA indica espesores desde 14 mm y pesos desde unos 1,4 kilos, con batería para todo el día. Son especificaciones de producto, no resultados de pruebas independientes.
Nemotron 3.5 Transcribe: un modelo para audio y habla
NVIDIA presentó Nemotron 3.5 Transcribe, un modelo de voz de pesos abiertos. Transcribe 40 idiomas, incluidos siete idiomas índicos, y añade etiquetado de hablantes y traducción en un solo modelo.
Los desarrolladores lo guían con instrucciones en lenguaje natural. Pueden pedir una transcripción con hablantes identificados, una traducción al inglés o un resumen de las decisiones de una reunión. Los prompts admiten vocabulario técnico y formatos concretos.
Como los pesos son abiertos, se elige dónde procesar el audio, del escritorio a la nube. NVIDIA afirma que ocupa el primer puesto en Open ASR de Hugging Face y el segundo entre modelos abiertos en Artificial Analysis, con unos 4.300 millones de parámetros activos. Está disponible en Hugging Face; las versiones cuantizadas para ejecutarlo en local llegarán más adelante.
Reparto de GPU entre apps y agentes en segundo plano
En RTX Spark pueden convivir agentes de larga duración con las aplicaciones habituales, y ambos comparten la GPU. La nueva función de gestión de recursos de NVIDIA App permite decidir ese reparto.
Puedes priorizar la aplicación en primer plano para máximo rendimiento, o dar más recursos al agente en segundo plano para que termine antes. El control está en System > Advanced de NVIDIA App.
Hay una condición: la función exige tener activada la planificación de GPU acelerada por hardware en los ajustes de Windows. Sin ese requisito cumplido, el control no está disponible.
LFM3 de Liquid AI: modelos compactos para tareas locales
Liquid AI presentó la familia LFM3, con modelos de texto, visión, audio, omni y decisión sobre una base compartida. Hay versiones base y postentrenadas con pesos abiertos.
Según la compañía, su modelo base de 1.700 millones de parámetros supera al anterior de 2.600 millones. Los usos locales incluyen agentes que clasifican correo, gestionan calendarios, leen documentos, transcriben voz o enrutan tickets de soporte.
En RTX Spark se ejecutan con soporte nativo mediante llama.cpp y vLLM, y se pueden ajustar en local. Son afirmaciones del fabricante sobre su familia de modelos, no comparativas medidas de forma independiente.
Agentes de IA para simulaciones con Omniverse
NVIDIA describe cómo los desarrolladores combinan modelos de IA de frontera con las bibliotecas de Omniverse para construir simulaciones. Dirigen a los agentes con instrucciones en lenguaje natural y revisan los resultados.
Las bibliotecas aportan física, renderizado y simulación de sensores acelerados por GPU. En un ejemplo, un miembro del equipo de NVIDIA usó Astra para reconstruir un edificio a partir de fotos panorámicas y nubes de puntos, con OpenUSD como formato de los modelos.
Otro caso simula una turbina de gas para comparar potencia, eficiencia y consumo bajo distintas condiciones. Son prototipos descritos por NVIDIA, no aplicaciones comerciales verificadas de forma externa.
Qué queda por comprobar antes de decidir
Las cifras de rendimiento, memoria y precisión proceden de NVIDIA o de Liquid AI. No he probado estos equipos ni estos modelos, así que trátalos como datos del anuncio.
La disponibilidad de los portátiles se describe a través de seis fabricantes, sin precios ni fechas por país en la información publicada. Si te interesa un modelo concreto, comprueba la configuración y el soporte local antes de comprar.
NVIDIA señala que las versiones cuantizadas de Transcribe llegarán más adelante para ejecutarlo en local en sistemas RTX Spark y DGX Spark, entre otros. Falta ver cómo rinden con cargas reales y cuánto consume esa memoria compartida.
Fuentes consultadas
Pregunta a Sir Compare:Explícame estos números
Qué ha cambiado
- Página actualizada
El correo de Sir Compare
¿Novedades sobre PC gaming, estaciones de trabajo e IA local? Te escribo yo.
Elige lo que te interesa: solo te escribo cuando sale algo nuevo — una guía, una noticia, un precio verificado que baja.
Paso 1 de 2
¿Qué te interesa?
Elige las que quieras. Si no eliges ninguna, recibes las novedades de todas las secciones.
- Solo lo que eliges
- Nunca un correo vacío
- Sales con un clic